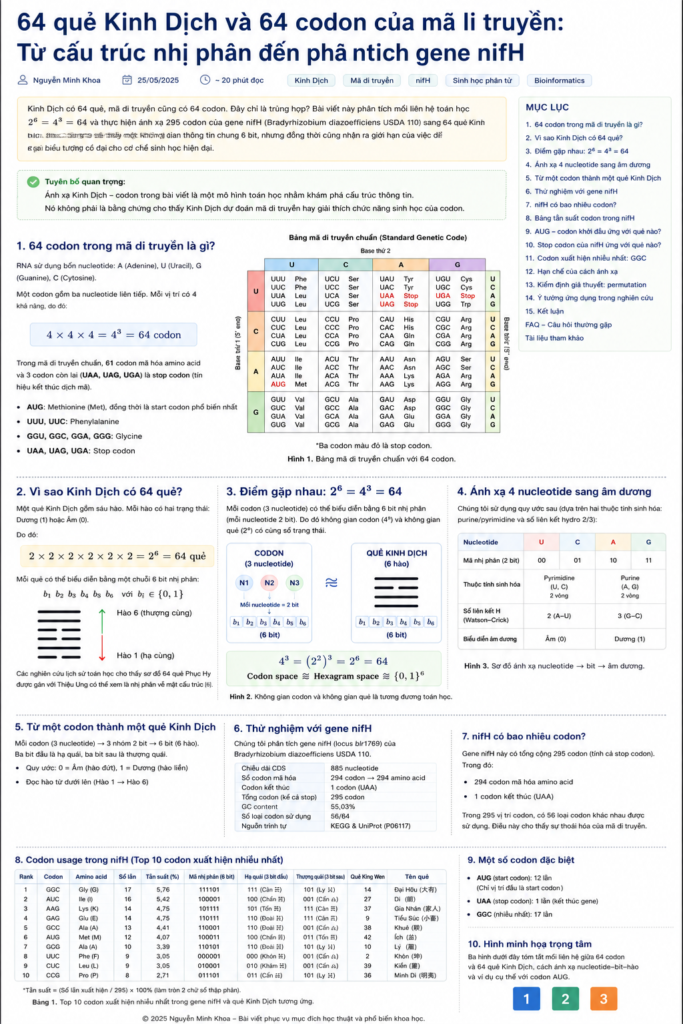
64 quẻ Kinh Dịch và 64 codon của mã di truyền: Từ cấu trúc nhị phân đến phân tích gene nifH
Từ khóa chính: 64 quẻ Kinh Dịch và 64 codon
Từ khóa phụ: Kinh Dịch và mã di truyền, gene nifH, genetic code, codon AUG, nitrogenase, mã nhị phân nucleotide.
Kinh Dịch và mã di truyền thuộc hai thế giới tri thức rất khác nhau. Kinh Dịch hình thành trong truyền thống tư tưởng cổ đại Đông Á, còn mã di truyền là một khái niệm trung tâm của sinh học phân tử hiện đại. Tuy vậy, cả hai cùng xuất hiện con số 64: Kinh Dịch có 64 quẻ, còn mã di truyền chuẩn có 64 codon.
Điều đáng chú ý không chỉ là sự trùng hợp số học. Một quẻ gồm sáu hào, mỗi hào có hai trạng thái; còn một codon gồm ba nucleotide, mỗi vị trí có bốn khả năng. Vì vậy 26 = 43 = 64. Về mặt lý thuyết thông tin, cả hai đều có thể được biểu diễn trong một không gian sáu bit. Bài viết này phân tích cấu trúc đó, sau đó thử áp dụng một quy ước ánh xạ cụ thể cho gene nifH của Bradyrhizobium diazoefficiens USDA 110.
1. Mã di truyền có 64 codon như thế nào?
RNA sử dụng bốn nucleotide cơ bản: adenine (A), uracil (U), guanine (G) và cytosine (C). Một codon là một bộ ba nucleotide liên tiếp trên mRNA. Vì mỗi trong ba vị trí có bốn lựa chọn nên số bộ ba có thể hình thành là:
4 × 4 × 4 = 43 = 64 codon
Theo mã di truyền chuẩn, 61 codon quy định amino acid và ba codon UAA, UAG, UGA làm tín hiệu kết thúc dịch mã. Nhiều amino acid có thể được mã hóa bởi nhiều codon khác nhau; đặc tính này gọi là tính thoái hóa của mã di truyền. NCBI trình bày rõ quá trình giải mã đủ 64 triplet và phân chia 61 sense codon với ba stop codon.[1]
AUG là trường hợp đặc biệt: codon này mã hóa methionine và thường đóng vai trò codon khởi đầu trong dịch mã. Tuy nhiên một AUG nằm bên trong vùng mã hóa chỉ đơn giản có thể quy định methionine; vị trí và bối cảnh mới quyết định vai trò start.
2. Vì sao Kinh Dịch có 64 quẻ?
Một quẻ Kinh Dịch gồm sáu hào. Mỗi hào có hai trạng thái cơ bản: hào Dương và hào Âm. Nếu coi hai trạng thái này như hai ký hiệu nhị phân, sáu vị trí độc lập tạo ra:
2 × 2 × 2 × 2 × 2 × 2 = 26 = 64
Do đó mỗi quẻ có thể biểu diễn bằng một chuỗi sáu trạng thái nhị phân. Một nghiên cứu lịch sử toán học của Maitre bàn trực tiếp về sơ đồ 64 quẻ Phục Hy gắn với Thiệu Ung và quan hệ hình thức của nó với số học nhị phân của Leibniz; tác giả nhấn mạnh rằng hai hệ có mục đích và cách xây dựng lịch sử khác nhau, nhưng sơ đồ 64 quẻ vẫn có tính nhị phân về cấu trúc.[4]
3. Điểm gặp nhau: 2⁶ = 4³ = 64
Đây là cầu nối toán học quan trọng nhất. Bốn trạng thái của một nucleotide có thể mã hóa bằng hai bit vì 4 = 2². Một codon gồm ba nucleotide vì vậy có thể biểu diễn bằng sáu bit:
43 = (22)3 = 26 = 64
Nói cách khác, không gian codon và không gian quẻ đều có 64 trạng thái và đều có thể ánh xạ vào tập {0,1}⁶. Đây là một đẳng cấu tổ hợp: nó chứng minh hai tập trạng thái có thể lập tương ứng một–một, nhưng không tự nó chứng minh hai hệ có chung nguồn gốc hay cùng ý nghĩa.

Hu, Petoukhov và Petukhova đã khảo sát I Ching, các nhóm nhị phân và cấu trúc mã hóa di truyền trong một bài tổng quan đăng năm 2017 trên Progress in Biophysics and Molecular Biology.[3] Công trình này là một ví dụ cho thấy mối liên hệ I Ching–genetic code đã được thảo luận trong văn liệu học thuật, dù các diễn giải của lĩnh vực này không đồng nghĩa với đồng thuận của sinh học phân tử về một quan hệ nhân quả.
4. Từ A, U, G, C sang hai bit: quy ước ánh xạ
Để biến một codon thành sáu bit, trước hết phải gán bốn nucleotide vào bốn mã nhị phân. Trong thử nghiệm này sử dụng quy ước:
| Nucleotide | Mã 2 bit | Phân loại vòng | Cặp Watson–Crick |
|---|---|---|---|
| U | 00 | Pyrimidine | A–U: 2 liên kết H |
| C | 01 | Pyrimidine | G–C: 3 liên kết H |
| A | 10 | Purine | A–U: 2 liên kết H |
| G | 11 | Purine | G–C: 3 liên kết H |
Cách mã hóa trên tạo hai phép phân chia nhị phân có ý nghĩa sinh hóa: purine/pyrimidine và hai/ba liên kết hydro trong cặp base chuẩn. Sau khi ba nucleotide được đổi thành ba cặp bit, ta thu được chuỗi sáu bit. Trong mô hình đang dùng, 0 được xem là Âm, 1 là Dương; các bit được gán lần lượt từ hào 1 đến hào 6 theo chiều dưới lên.

Điểm quan trọng là quy ước không duy nhất. Chỉ riêng phép gán bốn nucleotide vào bốn mã 00, 01, 10, 11 đã có 4! = 24 hoán vị. Nếu tiếp tục thay đổi hướng đọc hào, giá trị Âm/Dương hoặc cách chia hạ quái–thượng quái, số hệ ánh xạ có thể tăng thêm đáng kể.
5. Ví dụ: AUG → 100011 → quẻ 42 Ích
Áp dụng quy ước trên cho AUG:
- A → 10
- U → 00
- G → 11
Ghép lại:
AUG → 10 | 00 | 11 → 100011
Ba bit đầu 100 tạo hạ quái Chấn; ba bit sau 011 tạo thượng quái Tốn. Khi tra theo thứ tự quẻ King Wen được sử dụng trong mô hình, tổ hợp này tương ứng quẻ 42 – Ích (益).

Sự tương ứng này có thể gợi liên tưởng biểu tượng vì AUG thường là start codon còn “Ích” mang nghĩa tăng thêm/lợi ích trong diễn giải truyền thống. Tuy nhiên, đây là nơi cần tránh suy luận hậu nghiệm: nếu đổi quy ước nhị phân, AUG có thể rơi vào một quẻ hoàn toàn khác. Vì vậy không thể dùng sự “hợp nghĩa” này làm bằng chứng sinh học.
6. Thử nghiệm trên gene nifH của Bradyrhizobium diazoefficiens USDA 110
nifH mã hóa nitrogenase iron protein, thường được gọi là Fe protein của hệ nitrogenase. UniProt ghi nhận NifH của Bradyrhizobium diazoefficiens USDA 110 (P06117; locus blr1769) dài 294 amino acid và là một thành phần của phức hệ nitrogenase xúc tác cố định nitơ.[2]
Trong trình tự CDS được dùng cho phép tính của bài, vùng mã hóa dài 885 nucleotide. Chia theo frame dịch mã tạo 295 triplet, gồm 294 codon quy định amino acid và một codon kết thúc. Như vậy cần phân biệt rõ hai khái niệm:
- 64 loại codon là kích thước của bảng mã di truyền chuẩn.
- 295 vị trí codon là chiều dài theo triplet của CDS nifH cụ thể đang khảo sát, tính cả stop codon.
Gene nifH sử dụng bao nhiêu loại codon?
Trong phép phân tích trình tự, 56 trong tổng số 64 loại codon xuất hiện ít nhất một lần. Hàm lượng GC tính trên CDS khoảng 55,03%. Codon xuất hiện nhiều nhất là GGC với 17 lần; tiếp theo là AUC 16 lần; AAG và GAG cùng 14 lần; GCC 13 lần; AUG xuất hiện 12 lần.
| Codon | Số lần | Amino acid | Quẻ theo mô hình |
|---|---|---|---|
| GGC | 17 | Glycine | 14 – Đại Hữu |
| AUC | 16 | Isoleucine | 27 – Di |
| AAG | 14 | Lysine | 37 – Gia Nhân |
| GAG | 14 | Glutamate | 9 – Tiểu Súc |
| GCC | 13 | Alanine | 38 – Khuê |
| AUG | 12 | Methionine | 42 – Ích |
Start và stop trong nifH
Codon đầu của ORF là AUG. Theo mô hình trên, AUG ánh xạ thành quẻ 42 Ích. Tuy nhiên CDS có tổng cộng 12 AUG; chỉ AUG ở đầu ORF đóng vai trò start trong phép dịch mã này, còn các AUG nội tại mã hóa methionine.
Codon kết thúc của CDS khảo sát là UAA. Với U=00 và A=10, UAA trở thành 001010, tương ứng quẻ 39 – Kiển trong hệ ánh xạ này. Một lần nữa, sự tương ứng tên quẻ và chức năng “dừng” chỉ là một quan sát sau khi đã định nghĩa quy tắc, không phải bằng chứng rằng quẻ quyết định chức năng stop.
7. Giới hạn khoa học: tương đồng cấu trúc không đồng nghĩa quan hệ nhân quả
Ở mức toán học, phát biểu “64 codon có thể ánh xạ một–một với 64 quẻ” là hợp lệ nếu định nghĩa rõ một song ánh. Nhưng từ đó không thể suy ra “Kinh Dịch giải thích mã di truyền”. Hai mức lập luận hoàn toàn khác nhau.
- Ánh xạ nucleotide–bit không duy nhất.
- Thứ tự đọc hào và thứ tự quẻ có nhiều quy ước lịch sử.
- Mã di truyền có tính thoái hóa: 64 codon không tương ứng với 64 chức năng độc lập.
- Một số codon có thể thay đổi nghĩa trong các mã di truyền không chuẩn, cho thấy chức năng codon là vấn đề sinh học tiến hóa, không phải một bảng biểu tượng cố định.[5]
- Việc lựa chọn một ánh xạ sau khi đã biết kết quả dễ dẫn tới post-hoc pattern matching.
8. Hướng kiểm nghiệm tiếp theo
Permutation analysis
Tạo toàn bộ 24 hoán vị của A/U/G/C với 00/01/10/11, sau đó tính quẻ tương ứng cho từng codon. Nếu một đặc tính chỉ xuất hiện trong một hoặc vài hoán vị được chọn, nó nhiều khả năng phụ thuộc quy ước.
Sensitivity analysis
Đảo 0/1, đảo hướng đọc hào, đổi thứ tự nucleotide hoặc thay cách chia ba bit dưới – ba bit trên. Mục tiêu là tìm các đại lượng bất biến hoặc gần bất biến.
Không gian sáu bit
Mỗi codon có thể xem như một điểm trong hypercube sáu chiều. Khi codon biến đổi, khoảng cách Hamming có thể mô tả mức thay đổi trong biểu diễn. Hướng này phù hợp hơn với các câu hỏi về codon bias, synonymous/nonsynonymous substitution, mutation neighborhood, entropy và error minimization của genetic code.
9. Kết luận
Mối liên hệ chắc chắn nhất giữa 64 quẻ Kinh Dịch và 64 codon là mối liên hệ toán học: 26 = 43 = 64. Một quẻ có sáu vị trí nhị phân; một codon có ba vị trí tứ phân, tương đương sáu bit. Vì vậy có thể xây dựng một song ánh giữa hai tập 64 phần tử.
Trên gene nifH của B. diazoefficiens USDA 110, quy ước U=00, C=01, A=10, G=11 cho phép biến toàn bộ 295 triplet thành một chuỗi quẻ; trong đó AUG ánh xạ thành quẻ 42 Ích, UAA thành quẻ 39 Kiển và GGC – codon xuất hiện nhiều nhất – thành quẻ 14 Đại Hữu. Giá trị khoa học của bài toán nằm ở cấu trúc mã hóa, đối xứng và lý thuyết thông tin; mọi diễn giải sâu hơn cần được kiểm nghiệm bằng thống kê và dữ liệu sinh học độc lập.
FAQ – Câu hỏi thường gặp
Mã di truyền có bao nhiêu codon?
64 codon: 61 codon mã hóa amino acid và ba stop codon UAA, UAG, UGA.
Vì sao Kinh Dịch có 64 quẻ?
Sáu hào, mỗi hào có hai trạng thái, tạo 2⁶ = 64 tổ hợp.
64 quẻ và 64 codon có thực sự giống nhau?
Chúng có cùng số trạng thái và có thể biểu diễn bằng sáu bit, nhưng chức năng và nguồn gốc của hai hệ khác nhau.
AUG có phải luôn là quẻ Ích?
Không. Kết quả đó chỉ đúng trong quy ước ánh xạ sử dụng trong bài.
Kinh Dịch có dự đoán mã di truyền không?
Hiện chưa có bằng chứng khoa học đủ mạnh để khẳng định điều đó.
Gene nifH được khảo sát có bao nhiêu codon?
CDS dài 885 nt, gồm 294 codon mã hóa protein và một codon kết thúc, tổng cộng 295 triplet.
Tài liệu tham khảo
- Cooper GM. The Cell: A Molecular Approach – Expression of Genetic Information. NCBI Bookshelf. NCBI Bookshelf.
- UniProtKB. P06117 · NIFH_BRADU – Nitrogenase iron protein, Bradyrhizobium diazoefficiens USDA 110. UniProt P06117.
- Hu Z, Petoukhov SV, Petukhova ES. I-Ching, dyadic groups of binary numbers and the geno-logic coding in living bodies. Prog Biophys Mol Biol. 2017;131:354–368. doi:10.1016/j.pbiomolbio.2017.08.018. PubMed PMID 28935152.
- Maitre MJ. Is the Fuxi liushisi gua fangwei diagram attributed to Shao Yong binary? Science in Context. Cambridge Core.
- Stops making sense – For the people? FEBS Journal. 2023. PMC10196215.